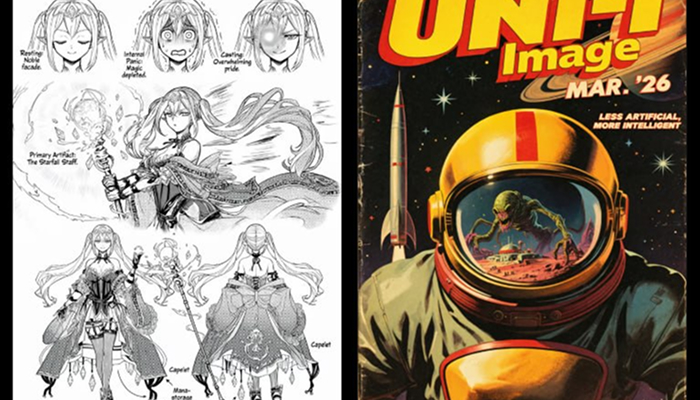
Luma представила Uni-1 — новую мультимодальную модель, которая объединяет понимание изображения и его генерацию в одной архитектуре, а не через разрозненные пайплайны. По словам компании, Uni-1 умеет «думать на языке и рендерить в пикселях» — сначала разбирает задачу, а уже потом строит сцену.
Что умеет Luma Uni-1
Главная идея Uni-1 — не просто нарисовать красивую картинку, а логически собрать сцену с учётом ограничений, композиции, пространства и причинно-следственных связей. Модель умеет работать с текстом и изображениями в едином конвейере, поддерживает референсы, принимает эскизы и визуальные подсказки, а также может переносить позы, композицию и внешний вид объектов в новое изображение.
Чем Luma Uni-1 отличается
В отличие от классических генераторов, Uni-1 основана на авторегрессионном трансформере, где текст и изображения обрабатываются как единая последовательность токенов. Такой подход помогает модели лучше следовать сложным инструкциям, планировать композицию заранее и сохранять контекст в многошаговом диалоге при доработке изображения.
Почему это важно
Luma заявляет, что Uni-1 показала лучший результат на RISEBench — бенчмарке для визуального редактирования с логическими и пространственными связями, немного опередив Nano Banana 2 и GPT Image 1.5. Кроме того, в задачах распознавания объектов модель почти достигает уровня Gemini 3 Pro, что говорит о сильной визуальной интерпретации, а не только о генерации.
Где попробовать
Luma уже открыла доступ к тестированию модели через своё приложение для креативной работы. Это важный апдейт для создателей контента, дизайнеров и всех, кто хочет получать не просто красивую картинку, а осмысленный визуальный результат по сложному запросу.
👉 Потестить: app.lumalabs.ai