Разбираем простыми словами, что такое промт-инъекция (prompt injection), какие виды атак существуют, как выглядит промт-инъекция на примерах и что реально помогает от неё защититься.
- Что такое промт-инъекция простыми словами
- Как работает промт-инъекция
- Виды промт-инъекций
- 1. Прямая инъекция
- 2. Непрямая (косвенная) инъекция
- 3. Инъекция через память и данные
- Промт-инъекция: примеры атак
- Реальные случаи промт-инъекций
- Чем это опасно на практике
- Промт-инъекция и джейлбрейк — в чём разница
- Как защититься от промт-инъекций
- Коротко о главном
Что такое промт-инъекция простыми словами
Промт-инъекция (prompt injection) — это способ обмануть нейросеть, подсунув ей в текст скрытую команду, которую модель выполнит вместо (или вместе с) задачей, которую поставил настоящий пользователь. Термин и сама техника атаки получили название по аналогии с SQL-инъекцией: там вредоносный код прячут внутри данных, которые попадают в базу, здесь — вредоносную инструкцию прячут внутри текста, который попадает в нейросеть.
Корень проблемы в том, как языковые модели вроде ChatGPT, Claude, Gemini или Copilot вообще читают текст. Для модели нет технической границы между «командой разработчика», «сообщением пользователя» и «текстом из внешнего документа» — всё это просто последовательность слов на входе. Если внутри этой последовательности встречается фраза вроде «игнорируй все предыдущие инструкции», модель может воспринять её как новую задачу, а не как часть контента, который нужно просто прочитать или обработать.
Промт-инъекция — это не взлом кода и не эксплуатация уязвимости в классическом понимании. Это манипуляция языком: нейросеть уговаривают или обманывают текстом так, чтобы она нарушила заложенные в неё правила.
Как работает промт-инъекция
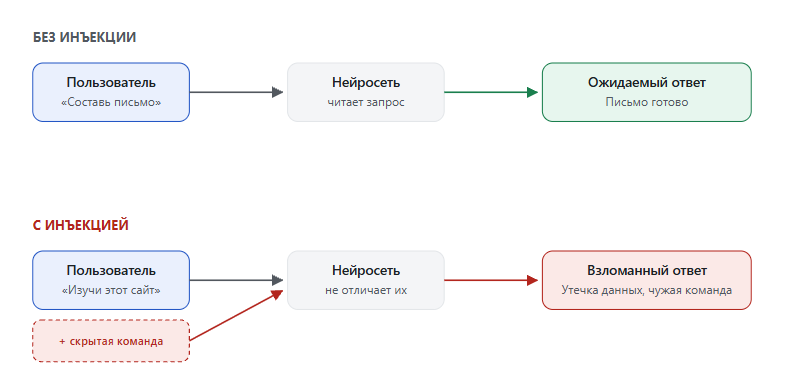
В обычной работе нейросеть получает системный промт (инструкции разработчика: кем быть, что можно, что нельзя) и запрос пользователя, а на выходе даёт ответ в рамках этих правил. Промт-инъекция вклинивается в этот процесс третьим, посторонним источником — текстом, который модель обрабатывает по ходу задачи: страницей сайта, письмом, документом, отзывом, описанием товара, резюме. Если в этом тексте спрятана инструкция, модель может принять её за часть своей задачи и выполнить, хотя ни разработчик, ни пользователь ничего подобного не просили.
Виды промт-инъекций
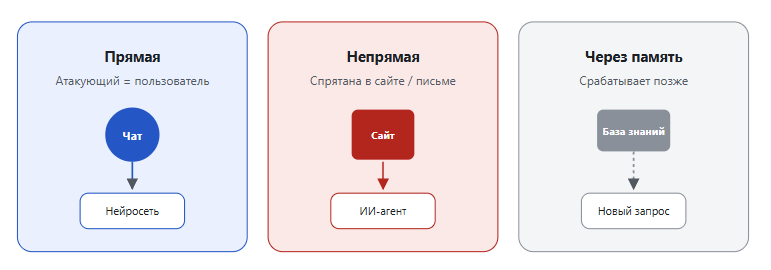
На практике выделяют три основных вида атак — они отличаются тем, откуда приходит вредоносная инструкция.
1. Прямая инъекция
Пользователь сам вводит вредоносную команду в чат — например, просит модель «забыть» системные правила и раскрыть скрытые инструкции или выполнить запрещённое действие. Это самый простой и самый известный вид атаки: именно так выглядели первые эксперименты с ChatGPT в 2022–2023 годах.
2. Непрямая (косвенная) инъекция
Вредоносная команда спрятана не в сообщении пользователя, а в контенте, который нейросеть обрабатывает по ходу задачи: на веб-странице, в письме, в PDF-документе, в описании товара, в резюме кандидата, в комментарии к посту. Пользователь может вообще не знать, что атака произошла — он просто попросил ИИ-агента «прочитать эту страницу» или «проверить почту». Именно этот вид с 2024–2025 годов стал основным для ИИ-агентов, которые самостоятельно ходят по интернету, читают документы и выполняют действия за пользователя.
3. Инъекция через память и данные
Вредоносная инструкция попадает в долговременную память ассистента, базу знаний или проиндексированные документы — и «срабатывает» не сразу, а позже, при следующих, совершенно не связанных запросах. Такие инъекции особенно опасны тем, что их сложно найти постфактум: заражённый текст мог попасть в систему недели назад.
Промт-инъекция: примеры атак
Чтобы понять, как промт-инъекция выглядит на практике, полезно разобрать пример прямой атаки и пример непрямой — они выглядят совсем по-разному.
Это классическая, «лобовая» промт-инъекция: пользователь напрямую просит модель проигнорировать правила. Современные версии ChatGPT, Claude и Gemini неплохо распознают такие явные попытки, но более аккуратные формулировки — через ролевую игру, вымышленный сценарий или «режим разработчика» — всё ещё иногда проходят.
Пользователь не видит эту строку в документе, но нейросеть читает файл целиком и может выполнить спрятанную команду вместо честной оценки резюме.
Такой же приём используют для обмана ИИ-модераторов рекламы, поисковых ассистентов и агентов, которые сами бронируют билеты или делают покупки: инструкцию прячут в HTML-коде страницы, в атрибутах тегов или сдвигают текст за пределы видимой области экрана.
Реальные случаи промт-инъекций
Исследователи показали, что инструкцию, спрятанную в публичном канале, ассистент Slack AI мог «прочитать» и затем передать конфиденциальные данные через ссылку, ведущую на сервер атакующего.
Обычное на вид письмо содержало скрытый промт. Copilot прочитал его в рамках рутинной задачи и без единого клика пользователя передал внутренние данные за пределы компании — первая массовая zero-click-атака на корпоративного ИИ-ассистента.
В объявление внедряли скрытый текст-инструкцию, которая заставляла ИИ-модератора одобрить рекламу мошеннического товара вместо того, чтобы её отклонить.
Чем это опасно на практике
Пока нейросеть — это просто чат-бот без доступа к чему-либо, кроме диалога, промт-инъекция максимум заставит её сказать что-то не то. Риски резко растут, когда у модели появляется доступ к трём вещам одновременно: чужим данным, непроверенному внешнему контенту и возможности что-то отправить наружу (письмо, запрос, платёж, файл). Такое сочетание в индустрии иногда называют «смертельным трио» — именно оно стоит почти за каждым серьёзным инцидентом.
Из этого вытекают конкретные риски: утечка личных или корпоративных данных, выполнение действий без ведома пользователя (покупки, переводы, отправка писем), обход фильтров безопасности и модерации, распространение дезинформации от имени доверенного ассистента, а для ИИ-агентов с доступом к коду — потенциальное выполнение произвольных команд на устройстве.
Промт-инъекция и джейлбрейк — в чём разница
Эти два термина часто путают, но у них разная цель. Джейлбрейк — это попытка заставить саму модель нарушить её собственные правила безопасности (например, выдать запрещённый контент), обычно от лица того же пользователя, который с ней общается. Промт-инъекция — это подмена задачи: модель заставляют выполнить чужую, постороннюю инструкцию вместо той, что дал ей владелец системы, причём атакующий и пользователь нередко — разные люди. На практике приёмы пересекаются: джейлбрейк часто используют как инструмент внутри инъекции, чтобы «уговорить» модель выполнить вредоносную команду.
Как защититься от промт-инъекций
Полностью исключить промт-инъекции сегодня не может ни один разработчик — это признают и создатели самих моделей. Но риск снижают несколько практических мер.
Для обычных пользователей: не подключайте ИИ-ассистентов с широкими правами (доступ к почте, файлам, оплатам) к обработке контента из непроверенных источников; относитесь настороженно, если ассистент вдруг «вспоминает» инструкции, которых вы не давали; проверяйте, какие действия ассистент собирается совершить, прежде чем подтверждать их, особенно если речь о деньгах или личных данных.
Для разработчиков: разделяйте в архитектуре доверенные инструкции и непроверенный контент, а не просто склеивайте их в один текстовый промт; ограничивайте права ИИ-агента минимально необходимым набором действий; добавляйте подтверждение человеком для чувствительных операций (перевод денег, отправка данных наружу, удаление файлов); фильтруйте и проверяйте вывод модели перед тем, как передать его дальше по цепочке; логируйте и мониторьте, какие инструменты и с какими параметрами вызывает агент, чтобы вовремя заметить аномалию.
Коротко о главном
- Промт-инъекция — атака, при которой в текст, который читает нейросеть, прячут постороннюю команду.
- Бывает прямой (в самом чате), непрямой (через сайты, письма, документы) и через долговременную память ассистента.
- Опаснее всего она для ИИ-агентов с доступом к данным и возможностью действовать самостоятельно — от чат-бота максимум получишь неверный ответ, от скомпрометированного агента — утечку данных или несанкционированное действие.
- Полной защиты не существует, но разделение инструкций и данных, ограничение прав агента и подтверждение важных действий человеком заметно снижают риск.